
上下文与记忆:长期记忆
3、长期记忆
3.1 基本理解
3.1.1 什么是长期记忆
短期记忆记录的是会话级别(线程,Thread)的数据,会话间不共享。
而长期记忆记录的是用户特定或应用级别的数据,任何会话都可以随时访问。
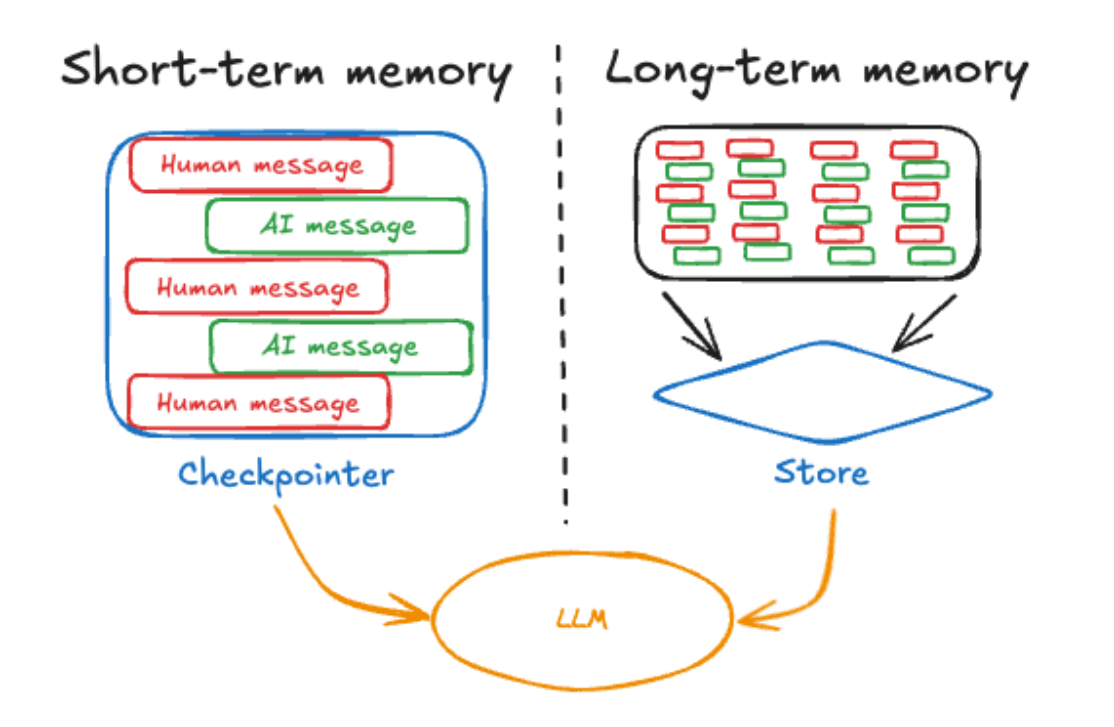
比如:
- 你喜欢简短回答
- 你偏好 Python
- 某个用户是 VIP
- 某个流程过去怎么做效果更好
这类信息不属于某一条聊天,而属于“用户/组织/应用本身”。
3.1.2 类型划分
LangChain参考CoALA paper(https://arxiv.org/pdf/2309.02427)将长期记忆划分为三类:
| Memory Type | 存什么 |
|---|---|
| Semantic(语义记忆)(https://docs.langchain.com/oss/python/concepts/memory#semantic-memory) | 事实 |
| Episodic(情景记忆)(https://docs.langchain.com/oss/python/concepts/memory#episodic-memory) | 经验 |
| Procedural(程序性记忆)(https://docs.langchain.com/oss/python/concepts/memory#procedural-memory) | 规则/做事方法 |
类型1:Semantic Memory(语义记忆)
即“事实类记忆”,记录事实/用户偏好/概念,如:
- 用户喜欢简洁回答
- 用户常用中文
- 某个公司属于哪个行业
类型2:Episodic Memory(情景记忆)
即“经验类记忆”,记录Agent过去执行的动作,如:
- 过去某个任务是怎么成功的
- 某种用户输入下,怎样回答效果最好
在Agent里,这常常表现为 few-shot examples(少样本示例):
不直接告诉模型规则,而是给它看几个“输入 -> 输出”的例子,让它照着学
类型3:Procedural Memory(程序性记忆)
即“规则/做事方法”,如
- Agent的系统提示词
- Agent的工作流程
- 工具调用规则
3.1.3 存储架构
长期记忆的存储是 store -> namespace -> key -> value的四层架构。
第1层:Store(记忆仓库)
- Store是 langgraph.store.base.BaseStore 的子类实例,由全类名可知,store是由LangGraph提供的。
- 常用实现类:
- InMemoryStore:将长期记忆存储在内存,适合测试
- PostgresStore:将长期记忆存储在外部的PostgreSQL数据库,适合生产环境开发期可用 InMemoryStore;生产建议数据库后端,如 PostgresStore
第2层:Namespace(命名空间)
数据类型是由任意长度的tuple[str, ...] 表示的层级路径。作用上很像“文件路径 / 文件夹层级”,用于给长期记忆分组和隔离。数据类型为字符串元组
第3层:Key(键)
是该 namespace 下的唯一标识,单条记忆的唯一键,数据类型为字符串(str)
第4层:Value(值)
是存储的值,数据类型为字典(dict[str, Any])
举例1:
每个namespace存储的都是key-value键值对,通过key可以唯一标识一条value。
namespace = ("users", "user_123", "preferences") # 元组类型
key = "profile"         # 字符串类型
value = {               # 字典类型
    "language": "zh-CN",
    "style": "short_direct",
    "likes": ["python", "rag"]
}
store.put(namespace, key, value)
举例2:
同一个 AI 应用通常会为每个独立会话维护各自的短期状态 State;而长期记忆通常可以共享同一个Store实例,再通过 namespace区分不同用户、组织、业务域或会话相关数据。如下:
AI应用
├─ thread_id = t1 -> state_1
│  ├─ messages = [
│  │    {"role": "user", "content": "我想去北京旅游"},
│  │    {"role": "assistant", "content": "你想玩几天?"}
│  │  ]
│  ├─ current_intent = "travel_planning"
│  └─ collected_slots = {"destination": "北京"}
│
├─ thread_id = t2 -> state_2
│  ├─ messages = [
│  │    {"role": "user", "content": "帮我写周报"}
│  │  ]
│  ├─ current_intent = "write_report"
│  └─ collected_slots = {}
│
├─ thread_id = t3 -> state_3
│  ├─ messages = [
│  │    {"role": "user", "content": "我喜欢简洁风格的UI"}
│  │  ]
│  ├─ current_intent = "ui_design"
│  └─ collected_slots = {"style": "minimal"}
│
└─ shared store
   ├─ namespace = (user_1, "memories")
   │  ├─ key = "profile"
   │  │  value = {
   │  │    "name": "张三",
   │  │    "city": "上海",
   │  │    "preferences": ["简洁风格", "中文回复"]
   │  │  }
   │  ├─ key = "travel_preference"
   │  │  value = {
   │  │    "favorite_cities": ["北京", "杭州"],
   │  │    "budget_level": "medium"
   │  │  }
   │  └─ key = "writing_style"
   │     value = {
   │       "tone": "professional",
   │       "language": "zh-CN"
   │     }
   │
   ├─ namespace = (user_2, "memories")
   │  ├─ key = "profile"
   │  │  value = {
   │  │    "name": "李四",
   │  │    "city": "深圳"
   │  │  }
   │  └─ key = "product_interest"
   │     value = {
   │       "topics": ["AI Agent", "RAG", "Workflow"]
   │     }
   │
   └─ namespace = (user_1, thread_3, "artifacts")
      ├─ key = "draft_v1"
      │  value = {
      │    "type": "html",
      │    "content": "<html>...</html>"
      │  }
      ├─ key = "ui_notes"
      │  value = {
      │    "summary": "用户偏好留白多、低饱和配色"
      │  }
      └─ key = "final_scheme"
         value = {
           "palette": ["#F5F1E8", "#1F3A5F", "#D97B2D"],
           "font_style": "clean"
         }
3.2 基础API的使用
LangChain 1.2.x 的长期记忆基于 store持久化数据,相关的API有:
- put():负责写入
- get():负责读取
- search():负责检索
我们可以在Agent执行流程之外直接访问长期记忆。
3.2.1 put()/get():写入/读取API
- ①put()源码剖析
直接调用put()函数即可,函数签名如下
def put(
    self,
    namespace: tuple[str, ...],
    key: str,
    value: dict[str, Any],
    index: Literal[False] | list[str] | None = None,
    *,
    ttl: float | None | NotProvided = NOT_PROVIDED,
) -> None:
参数说明
- namespace:文档所在的层级路径
- key:该路径下的唯一键
- value:要保存的 JSON-like 字典
- index:控制语义检索索引
- None(默认选项):使用 store 初始化时配置的索引配置,如果初始化时没有指定索引策略,则index参数将会被忽略
- False:不为该 item 建立语义索引
- list[str]:只对指定字段路径建索引
- ttl:可选,过期时间;是否支持取决于具体 store 实现
举例:
store.put(
    ("users", "alice", "memories"), # namespace
    "pref_food",                    # key
    {"category": "food", "text": "Alice likes sushi"} # value
)- ②get()源码剖析
按照 namespace + key 精确查询,返回的不止是value,而是完整对象。即LangGraph底层将数据封装为 Item 对象。
函数签名如下
def get(
    self,
    namespace: tuple[str, ...],
    key: str,
    *,
    refresh_ttl: bool | None = None,
) -> Item | None:
参数说明
- namespace:文档所在的层级路径
- key:该路径下的唯一键
- refresh_ttl:是否刷新当前item的ttl(time-to-live,存活时间)
- 默认为None:表示采用创建store对象时指定的同名配置如果没有配置TTL,该参数被忽略。
举例:
item = my_store.get(("users", "alice", "memories"), "pref_food")

if item is not None:
    print(item.value)
# {'category': 'food', 'text': 'Alice likes sushi'}- ③举例1:基于InMemoryStore
举例1:添加
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

namespace = ("users",)
user_id = 'user-1'
username = "小蓝"
store.put(namespace, user_id, {"name": username})

print(store.get(namespace, user_id))
输出
Item(namespace=['users'], key='user-1', value={'name': '小蓝'},created_at='2026-06-11T15:20:52.542493+00:00', updated_at='2026-06-注意到,Item对象新增了created_at 和updated_at 字段,分别为数据新增和更改时间。
注意:对于当前版本,InMemoryStore每次put都会创建一个新的Item对象,无论namespace和key是否相同,所以created_at 和updated_at 始终是一致的。
举例2:更新
对同一条数据进行更改后查询。
store.put(namespace, user_id, {"name": '小红'})
print(store.get(namespace, user_id))
输出
Item(namespace=['users'], key='user-1', value={'name': '小红'},created_at='2026-06-11T15:23:11.283981+00:00', updated_at='2026-06-- ④举例2:基于PostgresStore
PostgresStore不同于InMemoryStore,更改数据的逻辑是update而非覆盖,因此created_at 固定为Item 创建时间,而updated_at 为更新时间,二者可能不同,符合直觉。
举例1:添加
from langgraph.store.postgres import PostgresStore

namespace = ("users", )
user_id = "user-11"
username = "小蓝"

DB_URL ="postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable"
with PostgresStore.from_conn_string(DB_URL) as store:
    store.setup()
    store.put(namespace, user_id, {"name": username})
print(store.get(namespace, user_id))Item(namespace=['users'], key='user-11', value={'name': '小蓝'},created_at='2026-06-11T23:24:31.132342+08:00', updated_at='2026-06-说明:这里的DB_URL大家测试时,需要替换为自己的。
举例2:更新
更改同一条数据
with PostgresStore.from_conn_string(DB_URI) as store:
    store.setup()
    store.put(namespace, user_id, {"name": "小红"})
    print(store.get(namespace, user_id))
输出
Item(namespace=['users'], key='user-11', value={'name': '小红'},created_at='2026-06-11T23:24:31.132342+08:00', updated_at='2026-06-可以看到,created_at 没变,但updated_at 更改了。
3.2.3 search():检索API
- ①源码剖析
函数签名如下
def search(
    self,
    namespace_prefix: tuple[str, ...],
    /,
    *,
    query: str | None = None,
    filter: dict[str, Any] | None = None,
    limit: int = 10,
    offset: int = 0,
    refresh_ttl: bool | None = None,
) -> list[SearchItem]:
参数说明:
- namespace_prefix:命名空间前缀,在该前缀下搜索。
- query:语义检索时用于查询的自然语言。
- filter:过滤条件,value中的键值对组合,见下文举例。
- limit:可以返回item的最大条数,效果等同于SQL中的limit。
- offset:返回结果之前跳过的item数量。
- refresh_ttl:同上。
它支持两种检索方式(对应上面的参数2、3):
- 按 filter 做结构化过滤,即用 value 中的键值筛选符合条件的记录。
- 按 query 做语义相似度检索,需要将输入转换为向量。
返回值:
返回匹配的 SearchItem 列表,并额外携带匹配分数等检索元信息。
- ②举例1:按照namespace前缀搜索
本节全部基于InMemoryStore 测试。
1、准备store
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

namespace1 = ("users", "Alice", "memories")
key1 = 'preferences'
value1 = {
    "course": "计算机组成原理",
    "sports": "跑步",
    "food": "紫光园奶皮子酸奶"
}

namespace2 = ("users", "Bob", "memories")
key2 = 'preferences'
value2 = {
    "course": "数字电路与模拟电路",
    "sports": "跑步",
    "food": "奶皮子糖葫芦"
}

namespace3 = ("users", "Black", "memories")
key3 = 'preferences'
value3 = {
    "course": "数字电路与模拟电路",
    "sports": "羽毛球",
    "food": "紫光园奶皮子酸奶"
}

store.put(namespace1, key1, value1)
store.put(namespace2, key2, value2)
store.put(namespace3, key3, value3)
如果在jupyter环境,执行上述代码后,直接执行后续代码即可。
如果每次测试都在单独的python文件中进行,则以下1、2小节的案例代码之前都要补充上述代码。
2、按照namespace前缀搜索
代码1
print('=' * 30, '-> (users, ) <-', "=" * 30)
for item in store.search(("users", )):
    print(item)
输出
============================== -> (users, ) <-==============================
Item(namespace=['users', 'Alice', 'memories'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'},created_at='2026-06-11T15:27:24.734788+00:00', updated_at='2026-06-11T15:27:24.734789+00:00', score=None)
Item(namespace=['users', 'Bob', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '跑步', 'food': '奶皮子糖葫芦'},created_at='2026-06-11T15:27:24.734809+00:00', updated_at='2026-06-11T15:27:24.734810+00:00', score=None)
Item(namespace=['users', 'Black', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '羽毛球', 'food': '紫光园奶皮子酸
代码2
print('=' * 30, '-> (users, Alice) <-', "=" * 30)
for item in store.search(("users", "Alice")):
    print(item)
输出
============================== -> (users, Alice) <-==============================
Item(namespace=['users', 'Alice', 'memories'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'},- ③举例2:按照filter过滤
代码1
print("=" * 30, '-> (users, ), filter=food <-", "=" * 30)')
for item in store.search(("users", ), filter={"food": "紫光园奶皮子酸奶"}):
    print(item)
输出
============================== -> (users, ), filter=food <-", "=" * 30)
Item(namespace=['users', 'Alice', 'memories'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'},created_at='2026-06-11T15:27:24.734788+00:00', updated_at='2026-06-11T15:27:24.734789+00:00', score=None)
Item(namespace=['users', 'Black', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '羽毛球', 'food': '紫光园奶皮子酸
代码2
print("=" * 30, '-> (users, ), filter=sports <-", "=" * 30)')
for item in store.search(("users", ), filter={"sports": "跑步"}):
    print(item)
输出
============================== -> (users, ), filter=sports <-", "=" *30)
Item(namespace=['users', 'Alice', 'memories'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'},created_at='2026-06-11T15:27:24.734788+00:00', updated_at='2026-06-11T15:27:24.734789+00:00', score=None)
Item(namespace=['users', 'Bob', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '跑步', 'food': '奶皮子糖葫芦'},
代码3
print("=" * 30, '-> (users, ), filter=course <-", "=" * 30)')
for item in store.search(("users", ), filter={"course": "数字电路与模拟电路"}):
    print(item)
输出
============================== -> (users, ), filter=course <-", "=" *30)
Item(namespace=['users', 'Bob', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '跑步', 'food': '奶皮子糖葫芦'},created_at='2026-06-11T15:27:24.734809+00:00', updated_at='2026-06-11T15:27:24.734810+00:00', score=None)
Item(namespace=['users', 'Black', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '羽毛球', 'food': '紫光园奶皮子酸- ④举例3:按照语义搜索
举例1:自定义嵌入函数
自定义嵌入函数,目的是查看嵌入向量
from langgraph.store.memory import InMemoryStore
# 自定义嵌入函数
def embed(text: list[str]) -> list[list[float]]:
    return [[1.0] * 6 for _ in range(len(text))]

index_config = {
    "embed": embed,
    "dims": 6,
    "fields": ["$", "course"]
}
store = InMemoryStore(
    index = index_config
)

namespace1 = ("users", "Alice", "memories")
key1 = 'preferences'
value1 = {
    "course": "计算机组成原理",
    "sports": "跑步",
    "food": "紫光园奶皮子酸奶"
}

namespace2 = ("users", "Bob", "memories")
key2 = 'preferences'
value2 = {
    "course": "数字电路与模拟电路",
    "sports": "跑步",
    "food": "奶皮子糖葫芦"
}

namespace3 = ("users", "Black", "memories")
key3 = 'preferences'
value3 = {
    "course": "数字电路与模拟电路",
    "sports": "羽毛球",
    "food": "紫光园奶皮子酸奶"
}

store.put(namespace1, key1, value1)
store.put(namespace2, key2, value2)
store.put(namespace3, key3, value3)
初始化Store时通过index指定索引方式,后者源码如下
class IndexConfig(TypedDict, total=False):
    dims: int
    embed: Embeddings | EmbeddingsFunc | AEmbeddingsFunc | str
fields: list[str] | None- embeds:将输入文本转换为向量的嵌入函数,可以是自定义函数,也可以是嵌入模型对象,本例传递的是自定义嵌入函数。
- dims:输出向量维度
- fields:用于计算向量的属性列表,这里的属性都是指value中的key,value是一个JSON-like字典,可取值如下
- ["$"]:将value作为整体嵌入
- ["fileds1", "fields2"]:单独指定某个一级字段
- ["parent.child"]:从内部的嵌套JSON对象中获取子字段的值
- ["array[*].field"]:从JSON数组的每个JSON对象中获取子字段的值
- 注意:上述四种形式可以同时出现,fields列表的每个元素都会生成一个嵌入向量。
查看嵌入向量
from pprint import pprint
pprint(store._vectors)
输出
defaultdict(<function InMemoryStore.__init__.<locals>.<lambda> at0x000001C201898A40>,
         {('users', 'Alice', 'memories'): defaultdict(<class 'dict'>,
                                                      {'preferences':{'$': [1.0,
      1.0,
      1.0,
      1.0,
      1.0,
      1.0],
'course': [1.0,
           1.0,
           1.0,
           1.0,
           1.0,
           1.0]}}),
          ('users', 'Black', 'memories'): defaultdict(<class 'dict'>,
                                                      {'preferences':{'$': [1.0,
      1.0,
      1.0,
      1.0,
      1.0,
      1.0],
'course': [1.0,
           1.0,
           1.0,
           1.0,
           1.0,
           1.0]}}),
          ('users', 'Bob', 'memories'): defaultdict(<class 'dict'>,
                                                    {'preferences':{'$': [1.0,
    1.0,
    1.0,
    1.0,
    1.0,
    1.0],
'course': [1.0,
         1.0,
         1.0,
         1.0,
         1.0,
1.0]}})})还可以通过指定namespace、key、index_config的fields中指定的字段名查看特定向量。
from pprint import pprint
pprint(store._vectors[('users', 'Alice', 'memories')]['preferences']['$'])
输出
[1.0, 1.0, 1.0, 1.0, 1.0, 1.0]举例2:使用嵌入模型
本例要通过CloseAI平台调用OpenAI的嵌入模型openai:text-embedding-3-large
其嵌入维度为3072,所以此处的dims 应设置为3072
from langgraph.store.memory import InMemoryStore
from dotenv import load_dotenv
from langchain.embeddings import init_embeddings

import os
load_dotenv(override=True)

embedding_model = init_embeddings(
    model="openai:text-embedding-3-large",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL"),
)

index_config = {
    "embed": embedding_model,
    "dims": 3072,
    "fields": ["$"]
}
store = InMemoryStore(
    index = index_config
)

namespace1 = ("users", "Alice", "memories")
key1 = 'preferences'
value1 = {
    "course": "计算机组成原理",
    "sports": "跑步",
    "food": "紫光园奶皮子酸奶"
}

namespace2 = ("users", "Bob", "memories")
key2 = 'preferences'
value2 = {
    "course": "数字电路与模拟电路",
    "sports": "跑步",
    "food": "奶皮子糖葫芦"
}

namespace3 = ("users", "Black", "memories")
key3 = 'preferences'
value3 = {
    "course": "数字电路与模拟电路",
    "sports": "羽毛球",
    "food": "紫光园奶皮子酸奶"
}

store.put(namespace1, key1, value1)
store.put(namespace2, key2, value2)
store.put(namespace3, key3, value3)for item in store.search(("users", ), query="数电模电"):
print(item)输出
Item(namespace=['users', 'Bob', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '跑步', 'food': '奶皮子糖葫芦'},created_at='2026-06-11T15:45:13.161389+00:00', updated_at='2026-06-11T15:45:13.161391+00:00', score=0.22494289397943232)
Item(namespace=['users', 'Black', 'memories'], key='preferences', value={'course': '数字电路与模拟电路', 'sports': '羽毛球', 'food': '紫光园奶皮子酸奶'}, created_at='2026-06-11T15:45:13.748504+00:00', updated_at='2026-06-11T15:45:13.748506+00:00', score=0.21367212817763243)
Item(namespace=['users', 'Alice', 'memories'], key='preferences', value={'course': '计算机组成原理', 'sports': '跑步', 'food': '紫光园奶皮子酸奶'},注意:如果只是指定了query ,返回的是所有namespace 前缀满足要求的item 。底层会按照向量相似度计算查询和候选的score ,输出结果按照score 降序排列。可以结合limit 或filter 限制数据条数。这里不再演示。
3.3 在Agent运行图中访问长期记忆
我们可以在工具或中间件中访问长期记忆。
3.3.1 在工具中访问长期记忆
- ①基于InMemoryStore
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)from langchain_core.messages import HumanMessage
from typing import NotRequired
from langchain.agents import create_agent, AgentState
from langchain.tools import tool, ToolRuntime
from langgraph.store.memory import InMemoryStore
store = InMemoryStore()
class CustomState(AgentState):
user_id: NotRequired[str]
@tool(parse_docstring=True)
def save_user_info(name: str, runtime: ToolRuntime) -> str:
"""
将用户信息保存在长期记忆中
Args:
name: 用户名
Returns:
str: 保存状态
"""
runtime.store.put(("users",), runtime.state["user_id"], {"name": name})
return "saved"
@tool(parse_docstring=True)
def get_user_info(runtime: ToolRuntime) -> str:
"""
从长期记忆中读取用户信息
Returns:
str: 用户信息
"""
item = runtime.store.get(("users",), runtime.state["user_id"])
return str(item.value) if item else "unknown"
agent = create_agent(
model=model,
tools=[save_user_info, get_user_info],
store=store,
system_prompt="用户提及个人信息时及时记录,用户询问个人信息时尝试用工具检索",
state_schema=CustomState,
)
print("=" * 30, '-> 第一个会话(线程) <-', "=" * 30)
response1 = agent.invoke({
"messages": [HumanMessage("你好,很高兴认识你,我是小花")],
"user_id": "user-1"
})
for msg in response1["messages"]:
msg.pretty_print()
print("=" * 30, '-> 第二个会话(线程) <-', "=" * 30)
response2 = agent.invoke({
"messages": [HumanMessage("我是谁")],
"user_id": "user-1"
})
for msg in response2["messages"]:
msg.pretty_print()其中,CustomState扩展了 Agent 的标准状态。除了默认的 messages (历史消息列表)之外,还额外增加了一个 user_id 字段。这样,Agent 在运行过程中随时随地都能知道当前和它说话的用户 ID 是什么。
输出
============================== -> 第一个会话(线程) <-==============================
================================ Human Message=================================

你好,很高兴认识你,我是小花
================================== Ai Message==================================
Tool Calls:
save_user_info (call_dUFA22P95tnIrBc0fi2I0WLF)
Call ID: call_dUFA22P95tnIrBc0fi2I0WLF
 Args:
  name: 小花
================================= Tool Message=================================
Name: save_user_info

saved
================================== Ai Message==================================

你好,小花,很高兴认识你!
============================== -> 第二个会话(线程) <-==============================
================================ Human Message=================================

我是谁
================================== Ai Message==================================
Tool Calls:
get_user_info (call_cARiaT5NR0kUZDbMOpy0khqA)
Call ID: call_cARiaT5NR0kUZDbMOpy0khqA
Args:
================================= Tool Message=================================
Name: get_user_info

{'name': '小花'}
================================== Ai Message==================================

你是小花。
两次invoke没有通过config串联为起来,是两个独立的会话,但第二个会话可以访问第一个会话写入长期记忆的内容。
- ②基于PostgresStore
from typing import NotRequired

from langchain.agents import create_agent, AgentState
from langchain.tools import tool, ToolRuntime
from langgraph.store.postgres import PostgresStore

DB_URI ="postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable"

class CustomState(AgentState):
    user_id: NotRequired[str]

@tool(parse_docstring=True)
def save_user_info(name: str, runtime: ToolRuntime) -> str:
    """
    将用户信息保存在长期记忆中

    Args:
        name: 用户名

    Returns:
        str: 保存状态
    """
    runtime.store.put(("users",), runtime.state["user_id"], {"name": name})
    return "saved"

@tool(parse_docstring=True)
def get_user_info(runtime: ToolRuntime) -> str:
    """
    从长期记忆中读取用户信息

    Returns:
        str: 用户信息
    """
    item = runtime.store.get(("users",), runtime.state["user_id"])
    return str(item.value) if item else "unknown"

with PostgresStore.from_conn_string(DB_URI) as store:
    store.setup()
    agent = create_agent(
        model=model,
        tools=[save_user_info, get_user_info],
        store=store,
        system_prompt="用户提及个人信息时及时记录,用户询问个人信息时尝试用工具检索",
        state_schema=CustomState,
    )

    print("=" * 30, '-> 第一个会话(线程) <-', "=" * 30)
    response1 = agent.invoke({
        "messages": "你好,很高兴认识你,我是小花",
        "user_id": "user-1"
    })
    for msg in response1["messages"]:
        msg.pretty_print()

    print("=" * 30, '-> 第二个会话(线程) <-', "=" * 30)
    response2 = agent.invoke({
        "messages": "我是谁",
        "user_id": "user-1"
    })
    for msg in response2["messages"]:
        msg.pretty_print()
输出
============================== -> 第一个会话(线程) <-==============================
================================ Human Message=================================
你好,很高兴认识你,我是小花
================================== Ai Message==================================
Tool Calls:
save_user_info (call_CmfPqf4aahyt5LQIgcaCSTDy)
Call ID: call_CmfPqf4aahyt5LQIgcaCSTDy
 Args:
  name: 小花
================================= Tool Message=================================
Name: save_user_info

saved
================================== Ai Message==================================

你好,小花,很高兴认识你!有什么我可以帮你的吗?
============================== -> 第二个会话(线程) <-==============================
================================ Human Message=================================

我是谁
================================== Ai Message==================================
Tool Calls:
get_user_info (call_x6DPJGLsqwjMgRoXd62bD7ZZ)
Call ID: call_x6DPJGLsqwjMgRoXd62bD7ZZ
Args:
================================= Tool Message=================================
Name: get_user_info

{'name': '小花'}
================================== Ai Message==================================

你是小花。
查看PostgresSQL数据表
打开Xshell客户端
ubuntu@VM-0-6-ubuntu:~$ psqlpostgresql://langgraph_user:123456@localhost:5432/langgraph_db?sslmode=disable
psql (16.13 (Ubuntu 16.13-0ubuntu0.24.04.1))
Type "help" for help.

langgraph_db=>
查看表
langgraph_db=> \dt
                    List of relations
 Schema |         Name          | Type  |     Owner
--------+-----------------------+-------+----------------
 public | checkpoint_blobs      | table | langgraph_user
 public | checkpoint_migrations | table | langgraph_user
 public | checkpoint_writes     | table | langgraph_user
 public | checkpoints           | table | langgraph_user
 public | store                 | table | langgraph_user
 public | store_migrations      | table | langgraph_user
(6 rows)

langgraph_db=>新增两张Store相关的表store 和store_migrations 。
3.3.2 在中间件中访问长期记忆
- ①Node-style hooks中访问
以before_model 为例,其钩子函数签名如下
def before_model(self, state: StateT, runtime: Runtime[ContextT]) ->dict[str, Any] | None:Runtime 定义如下
@dataclass(**_DC_KWARGS)
class Runtime(Generic[ContextT]):
    context: ContextT = field(default=None)  # type: ignore[assignment]
    """Static context for the graph run, like `user_id`, `db_conn`, etc.

    Can also be thought of as 'run dependencies'."""

    store: BaseStore | None = field(default=None)
    """Store for the graph run, enabling persistence and memory."""

    stream_writer: StreamWriter = field(default=_no_op_stream_writer)
    """Function that writes to the custom stream."""

    previous: Any = field(default=None)
    """The previous return value for the given thread.

    Only available with the functional API when a checkpointer is provided.
    """
    ...
所以,我们可以通过runtime.store 在中间件中访问长期记忆。
- ②Wrap-style hooks中访问1. wrap_model_call
钩子函数签名如下
def wrap_model_call(
    self,
    request: ModelRequest[ContextT],
    handler: Callable[[ModelRequest[ContextT]], ModelResponse[ResponseT]],
) -> ModelResponse[ResponseT] | AIMessage | ExtendedModelResponse[ResponseT]:
ModelRequest 定义如下
@dataclass(init=False)
class ModelRequest(Generic[ContextT]):
    """Model request information for the agent.

    Type Parameters:
        ContextT: The type of the runtime context. Defaults to `None` if notspecified.
    """

    model: BaseChatModel
    messages: list[AnyMessage]  # excluding system message
    system_message: SystemMessage | None
    tool_choice: Any | None
    tools: list[BaseTool | dict[str, Any]]
    response_format: ResponseFormat[Any] | None
    state: AgentState[Any]
    runtime: Runtime[ContextT]
    model_settings: dict[str, Any] = field(default_factory=dict)
    ...
所以,可以通过request.runtime.store 访问长期记忆。
2. wrap_tool_call
钩子函数签名如下
def wrap_tool_call(
    self,
    request: ToolCallRequest,
    handler: Callable[[ToolCallRequest], ToolMessage | Command[Any]],
) -> ToolMessage | Command[Any]:
ToolCallRequest 定义如下
@dataclass
class ToolCallRequest:
    """Tool execution request passed to tool call interceptors.

    Attributes:
        tool_call: Tool call dict with name, args, and id from model output.
        tool: BaseTool instance to be invoked, or None if tool is not
            registered with the `ToolNode`. When tool is `None`,interceptors can
            handle the request without validation. If the interceptor calls`execute()`,
            validation will occur and raise an error for unregistered tools.
        state: Agent state (`dict`, `list`, or `BaseModel`).
        runtime: LangGraph runtime context (optional, `None` if outsidegraph).
    """

    tool_call: ToolCall
    tool: BaseTool | None
    state: Any
    runtime: ToolRuntime
    ...
ToolRuntime 定义如下
@dataclass
class ToolRuntime(_DirectlyInjectedToolArg, Generic[ContextT, StateT]):
    state: StateT
    context: ContextT
    config: RunnableConfig
    stream_writer: StreamWriter
    tool_call_id: str | None
    store: BaseStore | None
所以,可以通过request.runtime.store 访问长期记忆。
3.4 何时写入记忆
官方介绍了两种方式。
1.在主流程里写(hot path)
也就是:用户发消息,AI 一边回答,一边决定要不要记下来。
优点:
- 立即生效
- 下一轮马上能用
- 用户可感知,透明
缺点:
- 增加延迟
- 逻辑变复杂 2.在后台写(background)
就是先回答用户,记忆整理放到后台异步做。
优点:
- 主流程更快
- 记忆逻辑更独立
- 更适合批量整理
缺点:
- 不能立刻生效
- 要决定多久整理一次
- 触发时机不好选
工程上通常这么选:
- 用户偏好、账号资料:可热路径写
- 对话摘要、经验沉淀、行为分析:更适合后台写